

このガイドでは抽出 (構造化) API (
POST /2.0/ai/extract_structured) について説明します。カスタムコードを使用しないフォルダベースの抽出を行う場合は、BoxウェブアプリでBox Extractを構成してください。抽出の仕組み
Box AIは、変換、OCR、レイアウト解析を実行してから、スキーマに基づいてエージェントによる抽出ループを実行します。ユーザーは1つのリクエストにつき1つのファイルを送信します。処理時間は、ページ数とレイアウトの密度によりますが、通常10秒から45秒です。APIを使用する場合
- エージェントの上書き、トークンの制限、インラインフィールド、信頼度スコア、または既存のパイプラインへの統合など、プログラムを通じた制御が必要な場合には抽出 (構造化) APIを使用します。
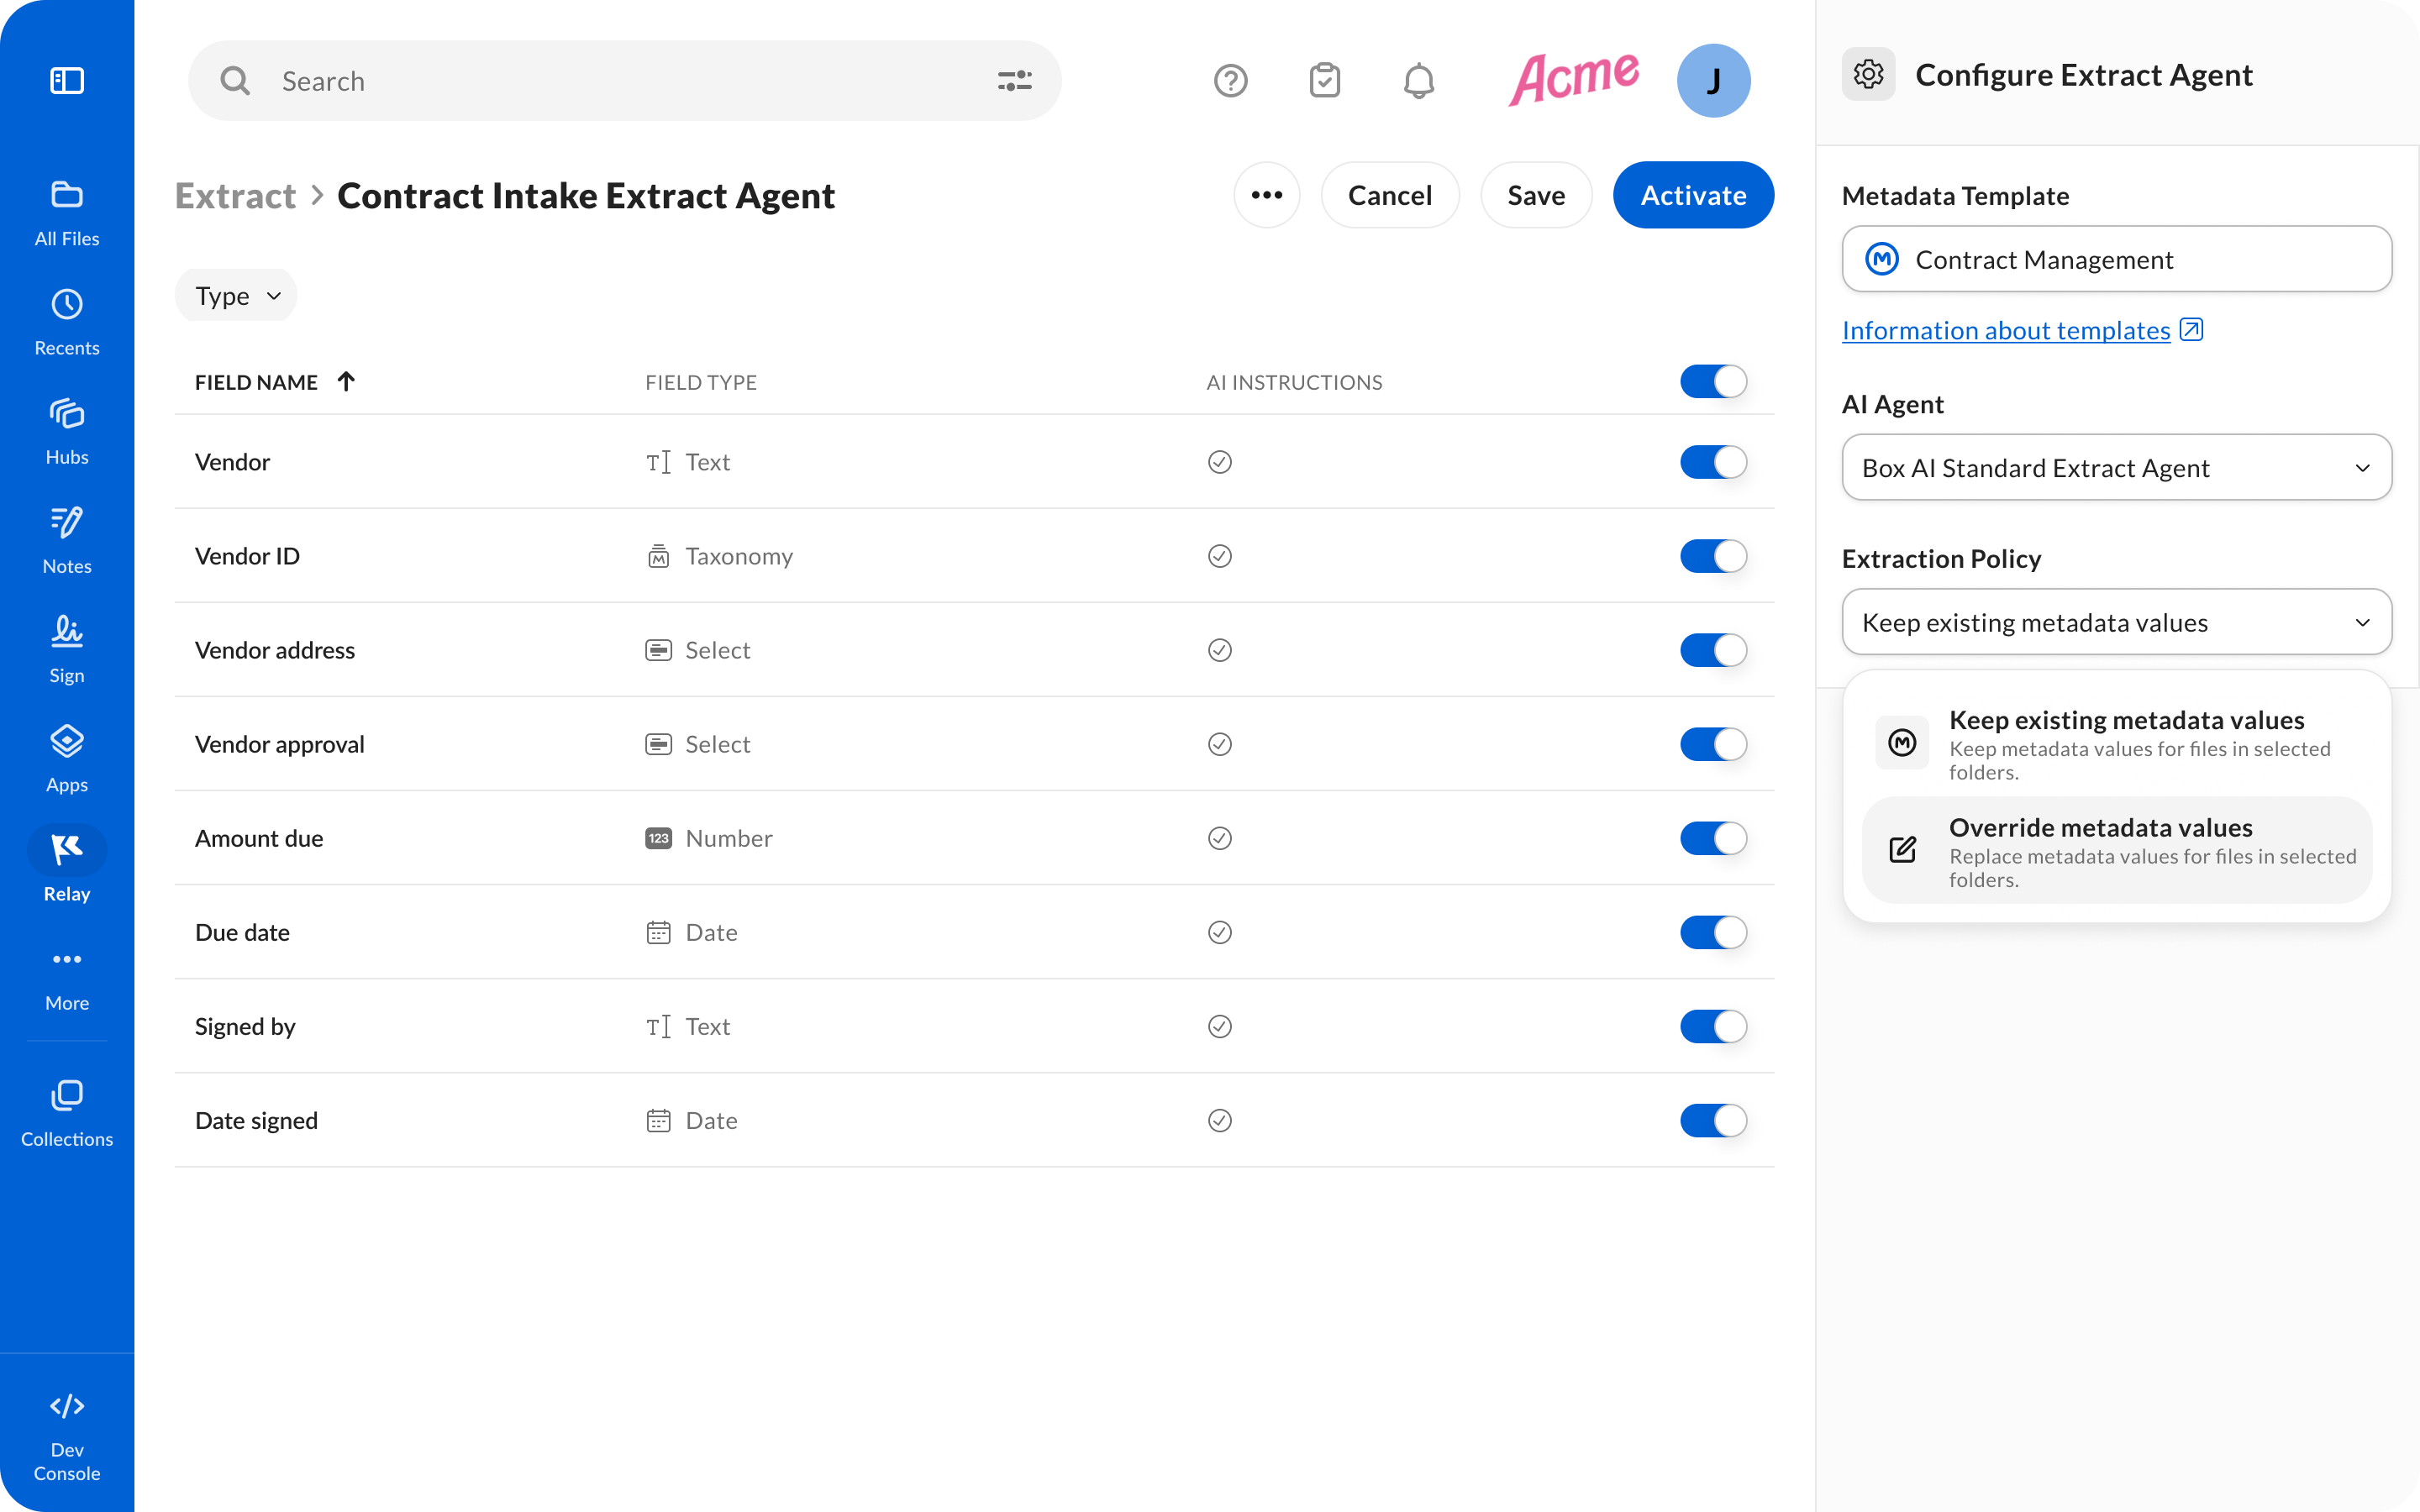
- ユーザーがフォルダにファイルをアップロードし、APIの調整を行わずに抽出する場合には、製品UIでBox Extractを使用します。Box Extractを使用すると、自分で統合を構築したり管理したりせずに済むため、開発の複雑さが減ります。詳細については、Box Extractを参照してください。
開始する前に
- 企業でBox AIが有効になっていることを確認します。
- 月間の処理キャパシティでワークロードに対応できることを確認します。大規模なバックフィルを行う場合は、ジョブを実行する前に、利用可能なキャパシティの引き上げをリクエストします。
- 大規模な移行またはアーカイブのバックフィルを行う場合は、キャパシティを計画できるようBoxアカウントチームに通知します。
- アプリで [AIを管理する] を有効にします。また、ファイルの読み取り (ファイルにメタデータを追加する場合は書き込みも) を有効にします。
- 本番実行の前に、少数のサンプルファイルでスキーマと期待される出力を確認します。
1つのファイルにつき1回抽出する設計
抽出ジョブはそれぞれ独立して実行されます。抽出されたメタデータは、Boxメタデータテンプレートを使用してファイルに保存するか、独自のストアに保存します。すでに正常な抽出結果があるファイルに対して、再度抽出を呼び出さないようにしてください。 スキーマが安定しており、Boxで値をインデックス化する場合は、メタデータテンプレートを使用します。1回のみ使用するスキーマやよく変更されるスキーマの場合は、インラインのfieldsを使用します。
リクエストの構成
エージェントを選択する
シンプルなドキュメントの場合は標準のエージェントで十分です。複数列のレイアウト、スキャンされたファイル、情報量の多い表、ネストされたstructフィールドやtableフィールドの場合は、抽出エージェント (強化) を使用します。
ai_agent_infoが含まれます。これを開発中にチェックして、上書きが有効であることを確認します。
クライアントのタイムアウトを設定する
HTTPクライアントのタイムアウトを120秒以上に設定します。これにより、モデルによる処理が続いている間に、複数ページのドキュメントがキャンセルされません。スキーマに含める項目を絞り込む
フィールドの数が多いと処理時間も長くなります。多数のフィールドがある場合は、関連するフィールドをグループ化して、より小さなテンプレートに分けてください。たとえば、1つのテンプレートに請求関連のフィールドをまとめて、別のフィールドにベンダーの連絡先情報をまとめます。長い回答のために完了に必要なトークン数を引き上げる
スキーマで長い要約、条項の抜粋、または多数の表の行を求める場合は、エージェントの上書きでnum_tokens_for_completionを引き上げます。
信頼度と引用情報を確認する
レビューを自動化するためにフィールドごとの信頼度とドキュメントの引用情報が必要な場合は、include_confidence_scoreとinclude_referenceをtrueに設定します。
出力は実行のたびにわずかに異なる場合があります。メタデータの書き込みや下流の作業のトリガーを行う前に、スキーマに照らして検証し、信頼度スコアを使用してください。
ペース調整と同時実行
- 8つ以上の並列ワーカーを実行します。
- それぞれのワーカーでは、必ず前のリクエストが完了してから次のリクエストを送信します。
- 小さいバッチから始めて、その後、同時実行数を増やしていきます。
- 可能な場合は、より短いドキュメントを先に処理します。50ページ程度のファイルやスキャン量の多いファイルはまとめて、ピーク時間外に処理します。
412または429が返された場合は、しばらく待ってから、クラスタのキャパシティが追い付くよう送信レートを少し下げて再開してください。
例: ペース調整したバッチランナー
次の例では、同時実行ワーカーと指数バックオフを使用し、JWT認証にbox_sdk_genを使用しています。ファイルIDとフィールドのリストはご自身のものに置き換えてください。
ステータスコード
サポート
抽出ジョブの失敗または遅延についてBoxサポートに問い合わせる場合は、以下の情報を含めてください。- レスポンスに含まれている
request_id - HTTPステータスとレスポンス本文
- ファイルIDとEnterprise ID
- リクエストのタイムスタンプとタイムゾーン
- フィールド定義またはメタデータテンプレートキー
- 同時実行とクライアントタイムアウトの設定